Des rapports directement depuis votre base ou votre entrepôt de données
Tous les rapports n’ont pas besoin de s’appuyer sur un tableau de bord. De nombreux rapports récurrents reposent sur une requête, un modèle et une liste de diffusion - et créer une couche BI uniquement pour les planifier est disproportionné.
Mail & Deploy se connecte directement aux bases de données SQL et à Snowflake, ainsi qu’à Databricks et à d’autres sources via ODBC. Vous définissez le jeu de données une seule fois, vous le liez à un modèle, puis la plateforme gère la génération, la personnalisation et la distribution selon une planification.
Vous recherchez des tableaux de bord et des analyses en libre-service ? Ce n’est pas l’objet de cette solution. Mail & Deploy produit et distribue des documents à partir de vos données - il ne remplace pas une plateforme BI. Si vos sources incluent Qlik ou Power BI, un même rapport peut exploiter l’ensemble de ces sources.
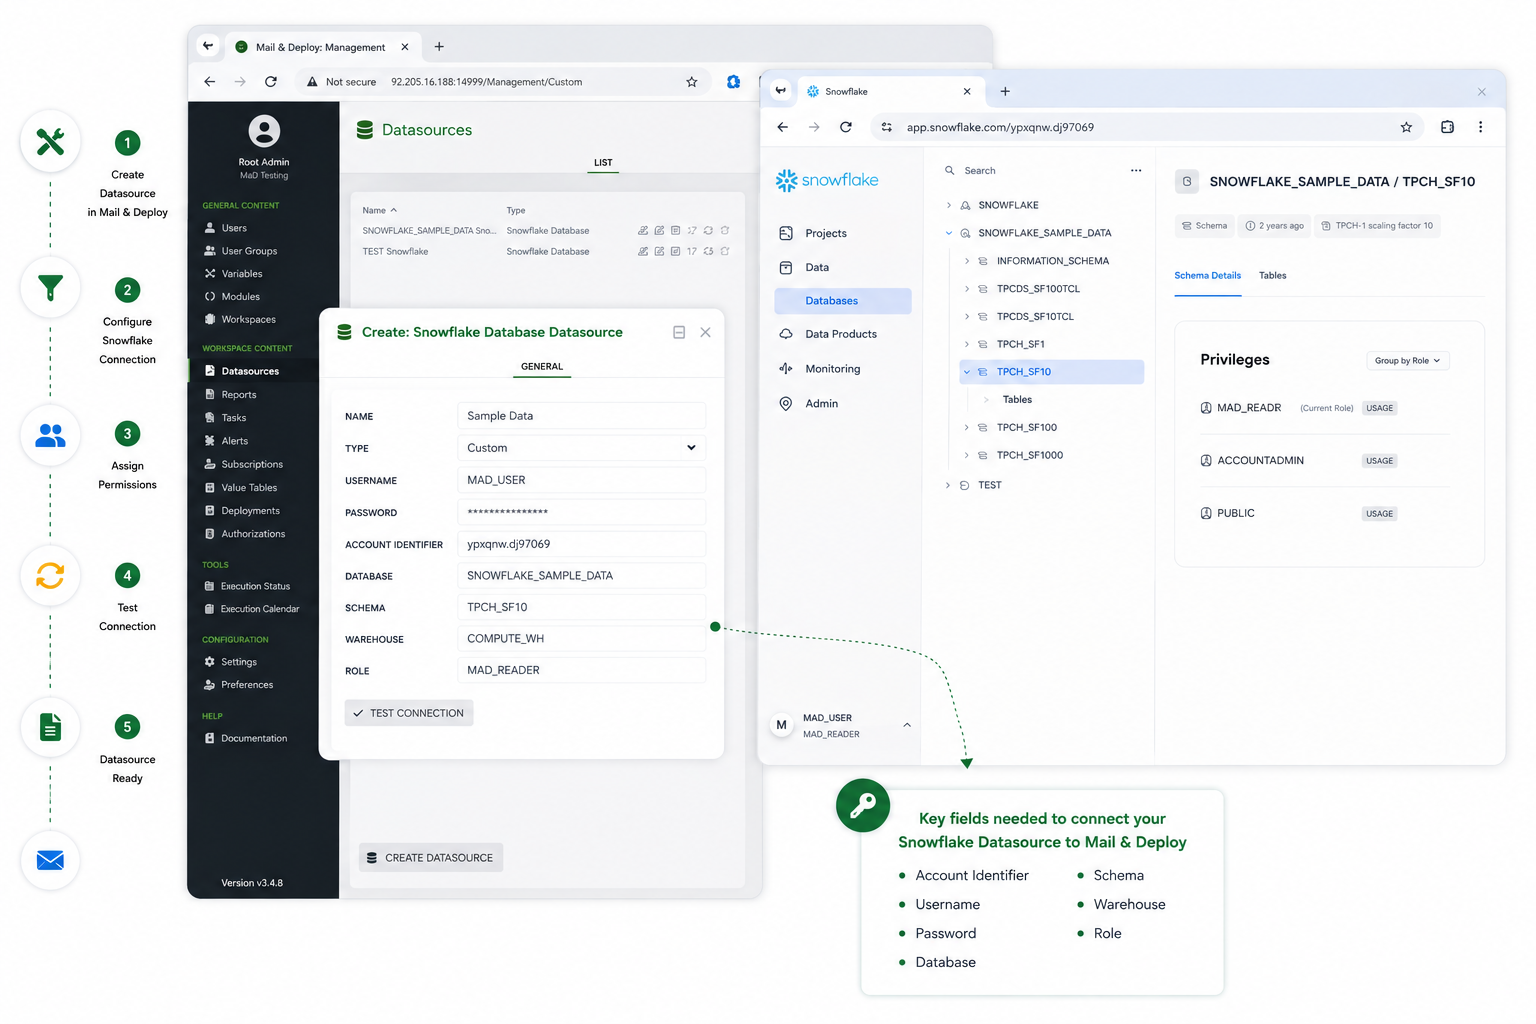
Connectez la source
Mail & Deploy se connecte directement à la base de données. Lors de la reconstruction du cache, il lit toutes les tables, les vues et leurs colonnes, afin que la conception des rapports s’appuie sur une structure connue plutôt que sur des requêtes en direct à chaque étape.
- Microsoft SQL Server
- MySQL
- Oracle
- Snowflake
- Google BigQuery
- tout pilote ODBC
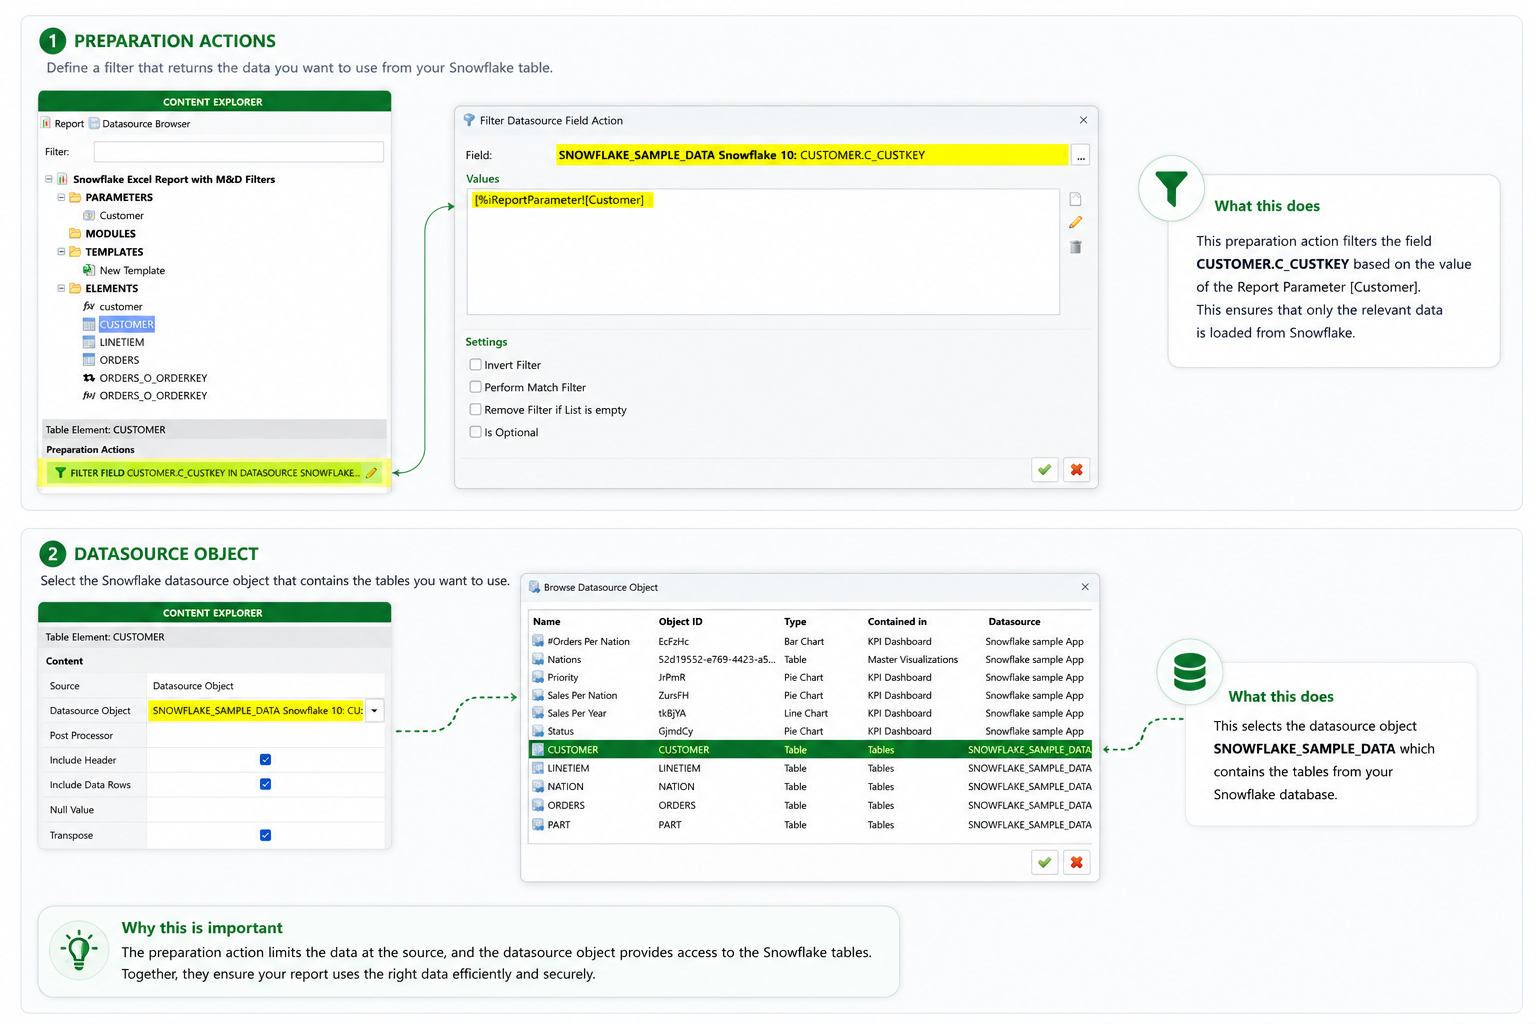
Un point à connaître : un filtre de champ s’applique à la table ou à la vue à laquelle ce champ appartient. Les tables liées ne sont pas filtrées automatiquement via les clés étrangères. Lorsque cela est nécessaire, placez la logique dans une vue maintenue par votre équipe de données.
Plusieurs sources peuvent être connectées simultanément, et un même rapport peut en exploiter plusieurs - notamment Qlik® et Power BI aux côtés de l’entrepôt de données. La liste complète des connecteurs figure dans la présentation des intégrations.
Définissez le jeu de données
Vous rédigez la requête ou vous référencez une vue déjà maintenue par votre équipe de données. La seconde option est généralement préférable : la logique de reporting qui réside dans l’entrepôt reste sous contrôle de version et cohérente avec tout ce qui repose sur elle.
Les requêtes acceptent des paramètres. Une plage de dates correspondant au « dernier mois terminé » au moment de l’exécution, ou une valeur de région fournie par la règle de bursting à l’étape 3, permet d’utiliser une seule définition de requête pour chaque exécution et chaque destinataire.
Les graphiques sont produits par le modèle plutôt que par la source. Un graphique Excel lié à une plage de données, ou un objet graphique dans le concepteur intégré, est redessiné à chaque exécution.
From here on, nothing depends on where the data came from. The template designer, the schedule and the delivery log look the same whether the source is Qlik®, Power BI or a database.
Chaque source de données supplémentaire fait l'objet d'une licence distincte.
Répartissez les données par destinataire
Choisissez une colonne pour le bursting - région, centre de coûts, responsable de compte, client. Mail & Deploy répartit le jeu de résultats selon les valeurs distinctes de cette colonne, remplit une copie du modèle par valeur et associe chaque document au bon destinataire.
Planifiez et distribuez
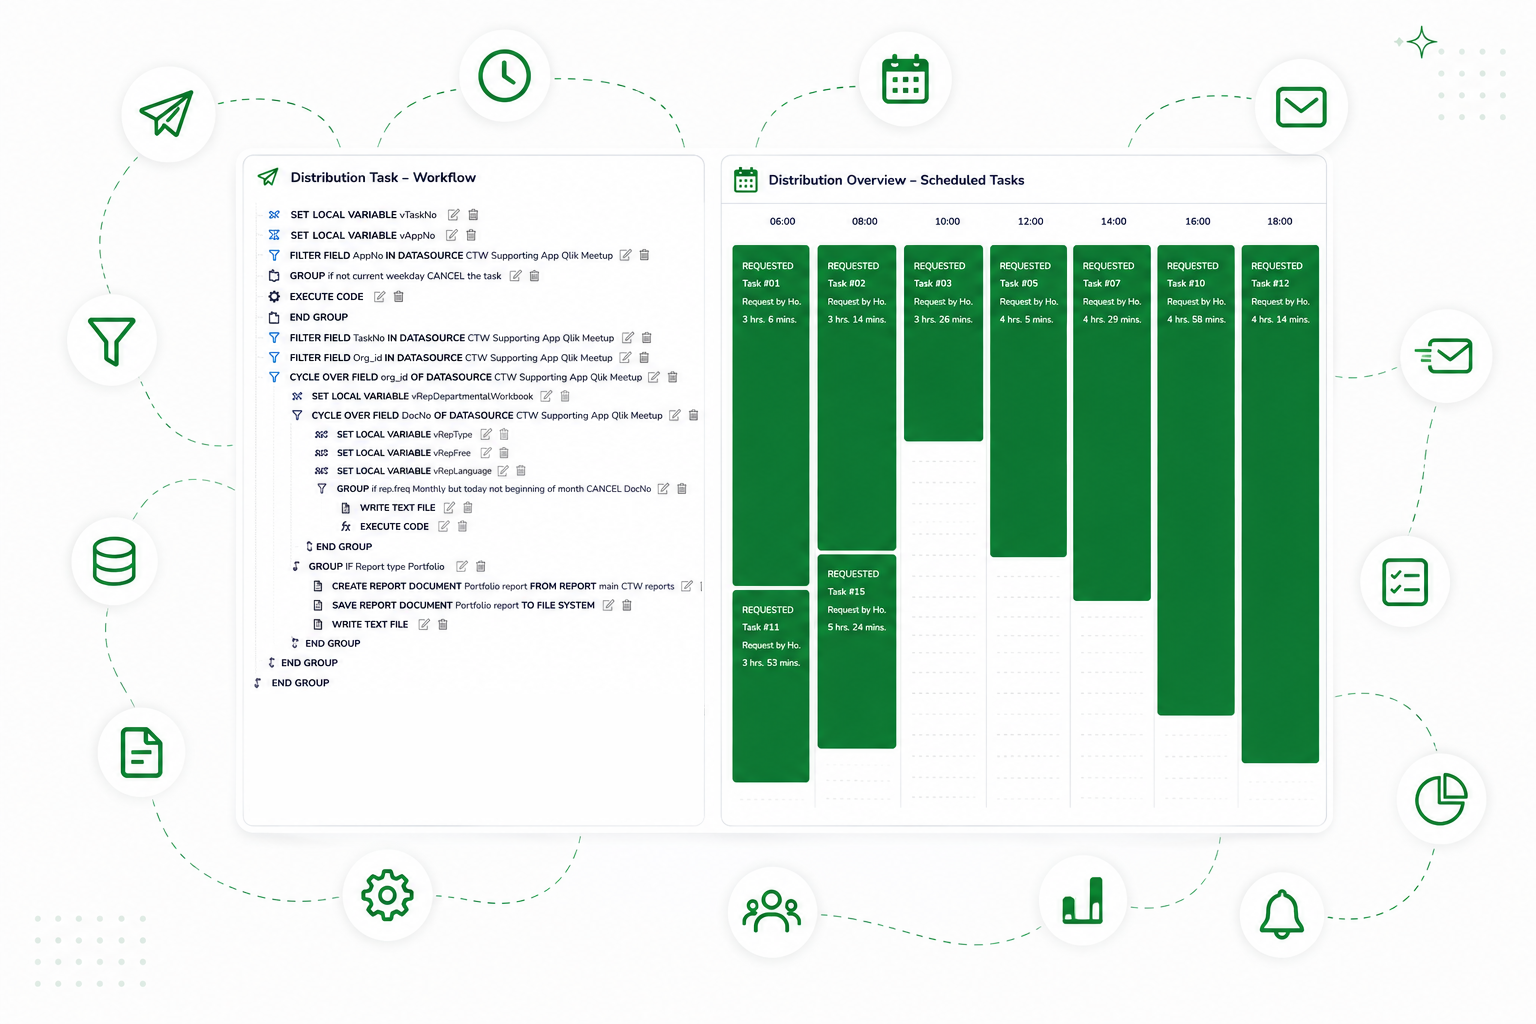
Les rapports s’exécutent selon la planification que vous définissez - tous les jours, toutes les semaines, tous les mois ou à une heure fixe.
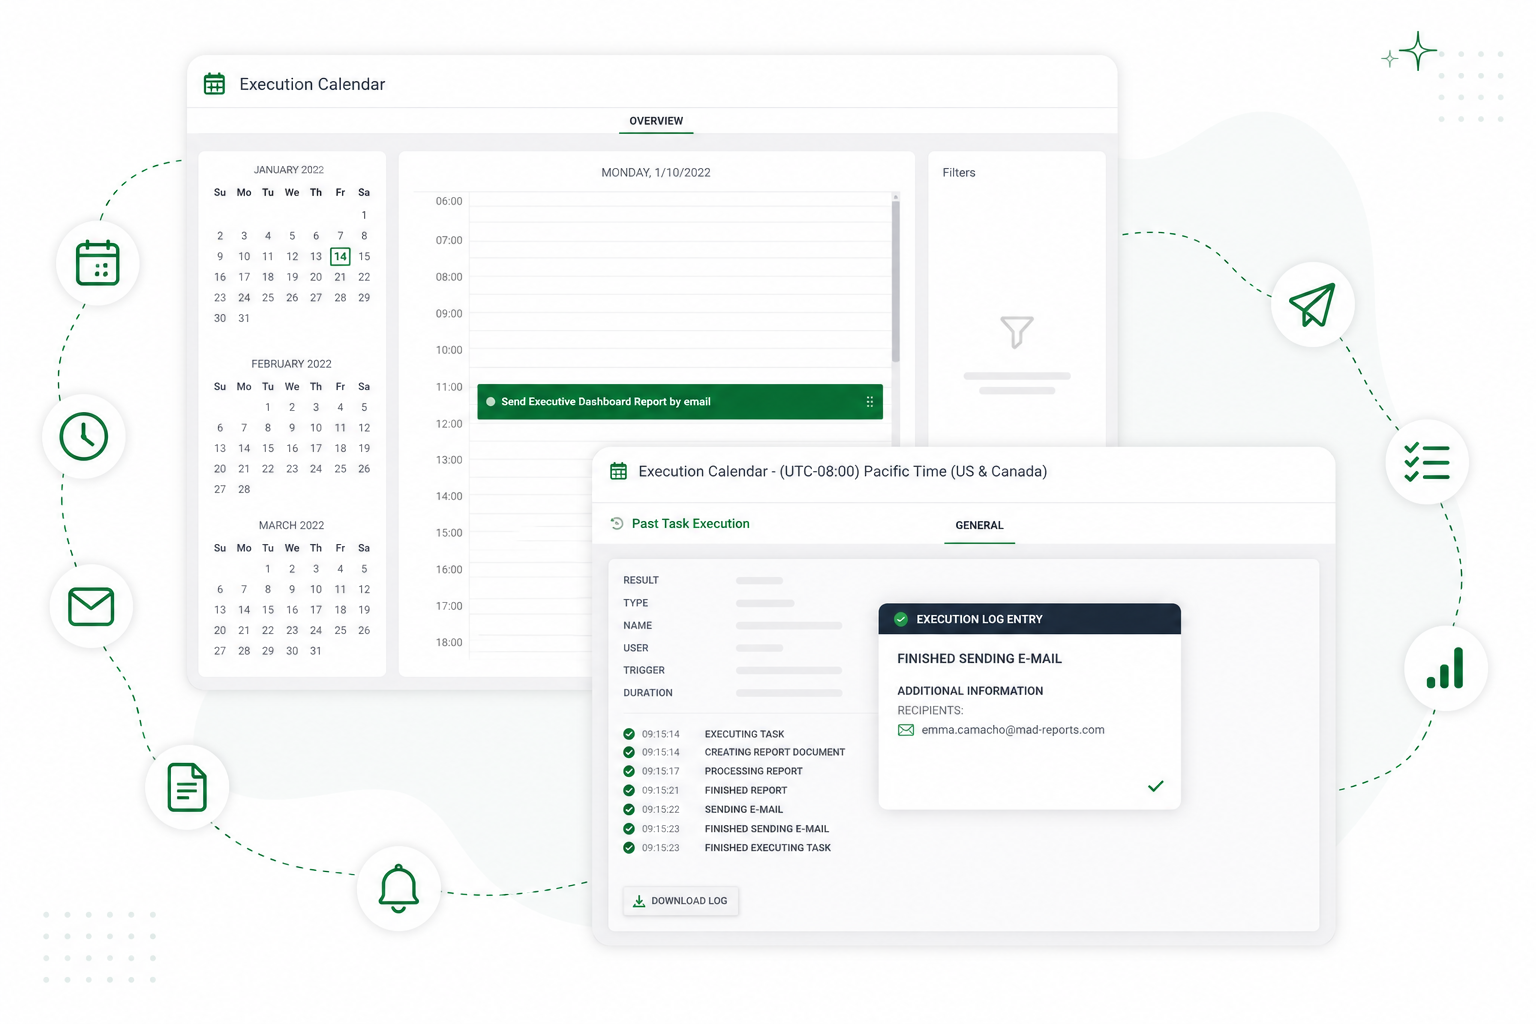
La distribution s’effectue par e-mail, serveur de fichiers, FTP, Microsoft SharePoint et Teams, OneDrive, Dropbox, AWS S3, Google Drive ou via le Mail & Deploy Hub. Chaque exécution est journalisée : ce qui a été exécuté, ce qui a été produit, la destination et les échecs.
Maintenir des coûts d’entrepôt prévisibles
Le reporting planifié consomme des ressources de calcul. Sur Snowflake, il s’agit de crédits, sur Databricks de DBU, et sur un service SQL managé, de capacité que vous avez déjà payée.
Mail & Deploy interroge la source une fois par destinataire. Un rapport destiné à deux cents destinataires implique deux cents requêtes. Tenez-en compte lors du dimensionnement de l’entrepôt et de la planification du rapport.
La maîtrise des coûts repose sur le calendrier d’exécution. Les rapports qui partagent une source peuvent être planifiés dans le même créneau, afin que l’entrepôt ne soit réactivé qu’une seule fois plutôt que plusieurs fois dans la matinée.
Les éléments nécessaires
- Édition de Mail & Deploy
- La plupart des configurations commencent avec l’édition Standard. Le choix dépend du nombre de destinataires, de la complexité des rapports et de votre utilisation de la distribution planifiée et du libre-service. Un échange téléphonique de quinze minutes permet de trancher plus vite qu’un tableau. Comparer les éditions.
- Prérequis
- Les prérequis matériels, logiciels et réseau actuels sont tenus à jour dans la documentation. Consulter les prérequis.
- Identifiants de connexion
- un compte ou un rôle dédié en lecture seule constitue la configuration habituelle
- Autorisations
- le rôle connecté voit exactement ce qu’il est autorisé à voir
Les détails par édition figurent dans la rubrique éditions et licences. Si l’un de ces points n’est pas clair pour votre environnement, un échange de quinze minutes avec notre équipe suffit, sans qu’il s’agisse d’une décision d’achat.
Un exemple concret
- Source
- Snowflake · vue ANALYTICS.REPORTING.SUPPLIER_KPI
- Paramètres
- semaine = dernière semaine ISO terminée
- Modèle
- Excel, mise en page de l’entreprise, graphique lié à une plage de données
- Champ de bursting
- SUPPLIER_ID → 64 résultats
- Planification
- Lundi 07:15 CET · une requête, 64 documents
- Distribution
- e-mail au contact du fournisseur · copie sur SharePoint
- Journal
- 64 générés · 63 livrés · 1 échec (adresse non valide)